[알고리즘] 최소 스패닝 트리(MST) 개념과 구현: 크루스칼 vs 프림 비교
TL;DR (세 줄 요약)
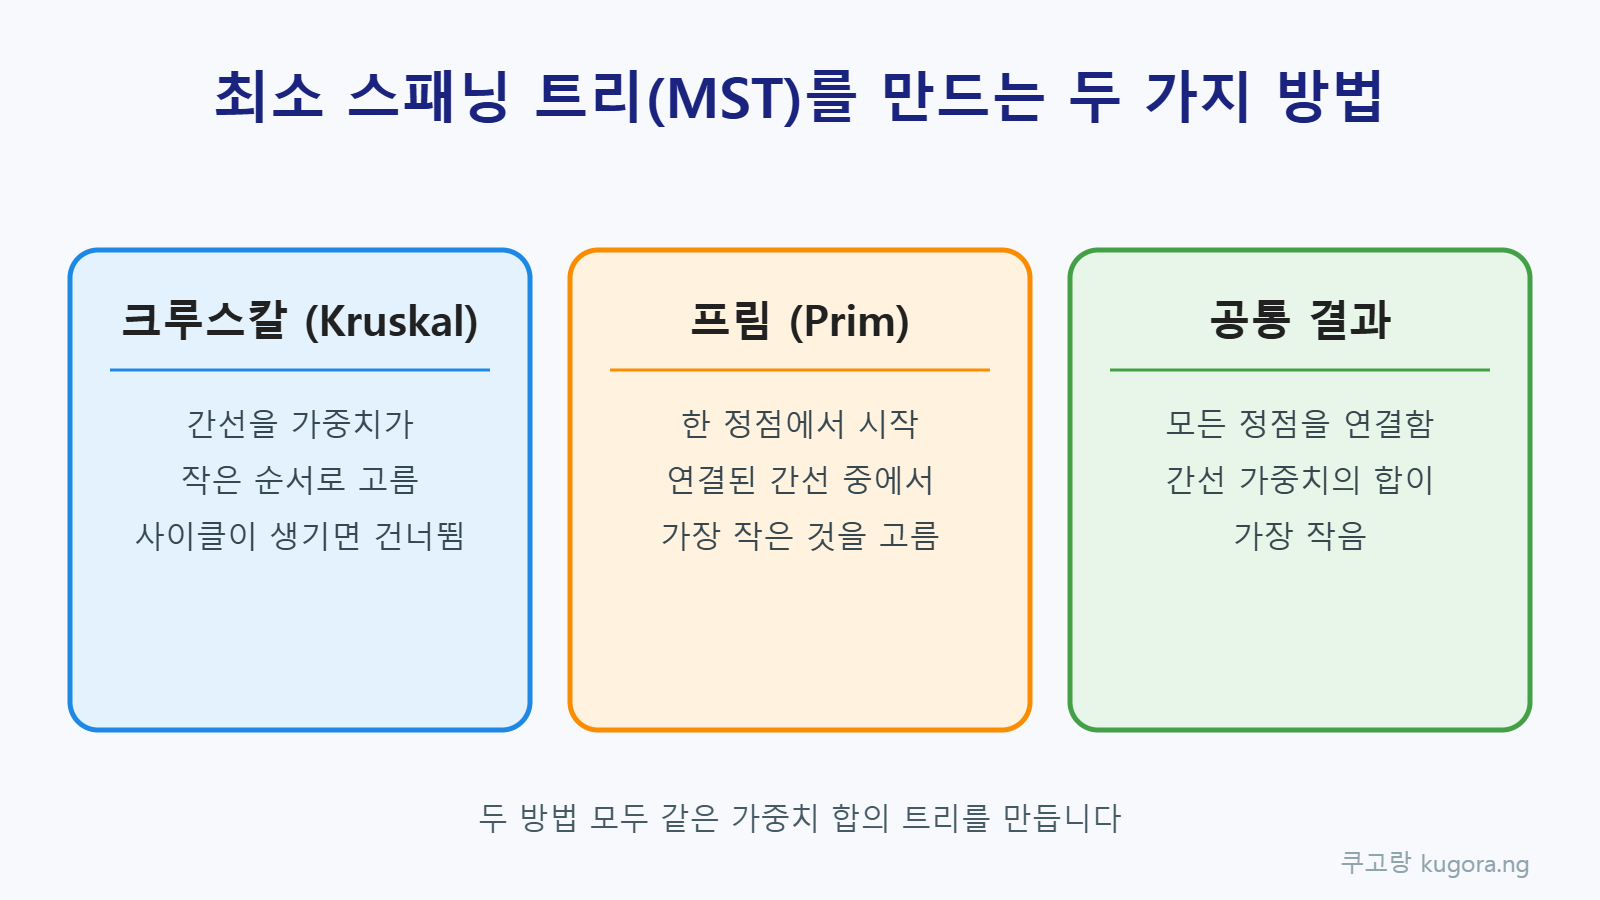
- 최소 스패닝 트리(MST)는 그래프의 모든 정점을 사이클 없이 연결하면서, 고른 간선의 가중치 합이 가장 작은 트리입니다.
- 프림 알고리즘은 정점 하나에서 시작해 가장 싼 간선으로 정점을 하나씩 붙입니다. 크루스칼 알고리즘은 모든 간선을 싼 순서로 보면서 사이클을 만들지 않는 간선만 고릅니다.
- 크루스칼에서 사이클이 생기는지는 유니온-파인드로 확인합니다. 백준 1197번은 간선 정렬과 유니온-파인드로 풀었습니다.
이 글은 2024년 1월 19일에 백준 1197번 "최소 스패닝 트리" 문제를 풀면서 정리한 기록입니다. 문제를 풀지 못해서 필요한 개념을 처음부터 하나씩 정리했고, 그 순서대로 설명합니다. 코드는 파이썬입니다.
1. 어떤 문제를 풀려고 했나요?
먼저 용어를 정리합니다. 그래프는 점과, 점과 점을 잇는 선으로 이루어진 구조입니다. 점을 정점(vertex), 선을 간선(edge)이라고 부릅니다. 간선에 붙은 숫자를 가중치(weight)라고 부릅니다. 이 문제에서 가중치는 두 정점을 연결하는 데 드는 비용입니다.
백준 1197번: 최소 스패닝 트리는 다음과 같은 문제입니다.
- 정점 V개(최대 10,000)와 간선 E개(최대 100,000)가 주어집니다.
- 간선마다 세 정수 A, B, C가 주어집니다. A번 정점과 B번 정점을 가중치 C로 잇는다는 뜻입니다.
- 모든 정점을 연결하는 데 드는 최소 비용을 구합니다.
문제 설명은 짧았습니다. 하지만 풀려면 다음 다섯 가지 개념이 필요했습니다.
- 최소 스패닝 트리(MST)
- 프림 알고리즘
- 크루스칼 알고리즘
- 우선순위 큐
- 유니온-파인드
오래 붙잡았지만 풀지 못했습니다. 정답 코드를 봐도 이해되지 않았습니다. 그래서 개념부터 정리했습니다.
2. 최소 스패닝 트리(MST)는 무엇인가요?
사이클은 한 정점에서 출발해 간선을 따라가다가 같은 간선을 다시 지나지 않고 출발한 정점으로 돌아오는 길입니다. 트리는 모든 정점이 연결되어 있고 사이클이 없는 그래프입니다.
스패닝 트리는 원래 그래프의 간선 중 일부만 골라서 만든 트리이고, 원래 그래프의 모든 정점을 포함합니다. 스패닝 트리는 여러 개 만들 수 있습니다. 그중 고른 간선의 가중치 합이 가장 작은 것이 최소 스패닝 트리(Minimum Spanning Tree, MST)입니다.
스패닝 트리와 신장 트리는 같은 말입니다. 스패닝 트리는 영어 spanning tree를 소리 나는 대로 적은 말이고, 신장 트리는 한자어로 옮긴 말입니다.
MST는 어떤 조건을 만족해야 하나요?
| 조건 | 뜻 |
| 무방향 | 간선에 방향이 없습니다. 간선 (u, v, w)는 u에서 v로도, v에서 u로도 갈 수 있다는 뜻입니다. |
| 비순환 | 사이클이 없어야 합니다. 사이클이 있으면 그 사이클의 간선 하나를 빼도 모든 정점이 여전히 연결됩니다. 꼭 필요하지 않은 간선이 들어 있다는 뜻이므로 트리가 아닙니다. |
| 연결 | 어떤 정점에서 출발해도 다른 모든 정점으로 갈 수 있어야 합니다. |
정점이 V개인 트리의 간선은 항상 V-1개입니다. 그래서 MST를 구한다는 말은 "간선 V-1개를 골라 모든 정점을 연결하되, 가중치 합을 가장 작게 만든다"는 뜻입니다.
3. 프림 알고리즘은 어떻게 동작하나요?
프림(Prim) 알고리즘은 정점 하나에서 시작합니다. 지금까지 연결한 정점들에서 바깥으로 나가는 간선 중 가장 싼 것을 골라 새 정점을 붙입니다. 모든 정점이 붙을 때까지 이 일을 반복합니다.
가장 싼 간선을 빠르게 고르려고 우선순위 큐를 씁니다. 우선순위 큐는 넣은 순서와 상관없이 가장 작은 값이 먼저 나오는 자료구조입니다. 파이썬에서는 heapq 모듈로 사용합니다.
- 시작 정점을 정하고 방문 집합에 넣습니다. 방문 집합은 이미 연결한 정점을 적어 두는 곳입니다.
- 방문 집합의 정점에서 나가는 간선을 우선순위 큐에 넣습니다.
- 큐에서 가장 싼 간선을 꺼냅니다. 그 간선의 끝 정점이 이미 방문한 정점이면 버립니다.
- 방문하지 않은 정점이면 방문 집합에 넣고 간선의 가중치를 비용에 더합니다. 그 정점에서 나가는 간선을 다시 큐에 넣습니다.
- 모든 정점을 방문하면 끝납니다.
파이썬 코드는 어떻게 생겼나요?
import heapq

def prim(graph, start):
    visited = set()
    min_heap = [(0, start)]   # (가중치, 정점)
    mst_cost = 0

    while min_heap:
        weight, vertex = heapq.heappop(min_heap)
        if vertex in visited:
            continue
        visited.add(vertex)
        mst_cost += weight
        for next_vertex, next_weight in graph[vertex]:
            if next_vertex not in visited:
                heapq.heappush(min_heap, (next_weight, next_vertex))
    return mst_cost

graph = {
    'A': [('B', 2), ('C', 3)],
    'B': [('A', 2), ('C', 1)],
    'C': [('A', 3), ('B', 1)],
}
print(prim(graph, 'A'))   # 3
min_heap = [(0, start)]: 시작 정점을 가중치 0으로 큐에 넣습니다. 큐의 항목은 (가중치, 정점) 꼴입니다.heapq.heappop(min_heap): 가중치가 가장 작은 항목을 꺼냅니다.if vertex in visited: continue: 이미 방문한 정점이면 버리고 다음 항목으로 넘어갑니다.visited.add(vertex),mst_cost += weight: 정점을 방문 집합에 넣고 가중치를 비용에 더합니다.for반복문: 방금 붙인 정점에서 나가는 간선 중, 아직 방문하지 않은 정점으로 가는 간선을 큐에 넣습니다.
예제 그래프에는 정점 A, B, C가 있습니다. 간선은 A-B(2), A-C(3), B-C(1)입니다. A에서 시작하면 다음 순서로 진행합니다.
- (0, A)를 꺼냅니다. A를 방문하고 비용은 0입니다. (2, B)와 (3, C)를 큐에 넣습니다.
- (2, B)를 꺼냅니다. B를 방문하고 비용은 2가 됩니다. (1, C)를 큐에 넣습니다.
- (1, C)를 꺼냅니다. C를 방문하고 비용은 3이 됩니다.
- 큐에 남은 (3, C)를 꺼냅니다. C는 이미 방문했으므로 버립니다.
결과는 3입니다. A-B(2)와 B-C(1) 두 간선으로 세 정점이 모두 연결됩니다.
방문 집합은 왜 쓰나요?
우선순위 큐에는 같은 정점으로 가는 간선이 여러 번 들어갈 수 있습니다. 위 예제에서도 C로 가는 간선이 (3, C)와 (1, C) 두 번 들어갔습니다. 방문 집합이 있으면 이미 붙인 정점을 다시 붙이지 않습니다. 그래서 같은 정점의 비용을 두 번 더하지 않고, 사이클도 생기지 않습니다.
4. 크루스칼 알고리즘은 어떻게 동작하나요?
크루스칼(Kruskal) 알고리즘은 정점이 아니라 간선을 기준으로 봅니다.
- 모든 간선을 가중치가 작은 것부터 큰 것 순서(오름차순)로 정렬합니다.
- 앞에서부터 간선을 하나씩 봅니다.
- 그 간선을 넣어도 사이클이 생기지 않으면 고릅니다. 사이클이 생기면 건너뜁니다.
- 간선 V-1개를 고르면 끝납니다.
여기서 필요한 것은 "이 간선을 넣으면 사이클이 생기는가"를 빠르게 확인하는 방법입니다. 이 확인에 유니온-파인드를 씁니다.
5. 유니온-파인드로 사이클을 어떻게 확인하나요?
유니온-파인드(Union-Find)는 원소들이 어느 집합에 속하는지 관리하는 자료구조입니다. 집합마다 대표 원소가 하나 있고, 이것을 루트(root)라고 부릅니다. 각 원소는 자기 집합의 루트를 찾아갈 수 있습니다. 두 원소의 루트가 같으면 같은 집합이고, 다르면 다른 집합입니다.
| 연산 | 하는 일 |
find(x) | x가 속한 집합의 루트를 찾습니다. 찾는 길에 지나간 원소를 루트에 바로 연결해 두면 다음 호출이 빨라집니다. 이것을 경로 압축이라고 부릅니다. |
union(x, y) | x가 속한 집합과 y가 속한 집합을 하나로 합칩니다. 한쪽 루트를 다른 쪽 루트에 붙입니다. |
connected(x, y) | find(x)와 find(y)가 같은지 확인합니다. |
크루스칼에서는 이미 연결된 정점들을 한 집합으로 관리합니다. 간선의 두 끝 정점이 같은 집합에 있으면 두 정점은 이미 연결된 상태입니다. 이때 그 간선을 넣으면 사이클이 생깁니다. 그래서 두 정점의 루트가 다를 때만 간선을 고르고 두 집합을 합칩니다.
class UnionFind:
    def __init__(self, size):
        self.root = [i for i in range(size + 1)]

    def find(self, x):
        if self.root[x] == x:
            return x
        self.root[x] = self.find(self.root[x])   # 경로 압축
        return self.root[x]

    def union(self, x, y):
        root_x, root_y = self.find(x), self.find(y)
        if root_x != root_y:
            self.root[root_y] = root_x

    def connected(self, x, y):
        return self.find(x) == self.find(y)

def kruskal(edges, v):
    uf = UnionFind(v)
    edges.sort(key=lambda e: e[2])   # 가중치 오름차순
    cost = 0
    for u, w, weight in edges:
        if not uf.connected(u, w):
            uf.union(u, w)
            cost += weight
    return cost

edges = [(0, 1, 10), (0, 2, 6), (0, 3, 5), (1, 3, 15), (2, 3, 4)]
print(kruskal(edges, 4))   # 19
self.root = [i for i in range(size + 1)]: 처음에는 모든 원소가 자기 자신을 루트로 가리킵니다. 원소마다 혼자서 집합 하나를 이룹니다.find:self.root[x] == x이면 x가 루트입니다. 아니면 위로 올라가 루트를 찾고, 찾은 루트를self.root[x]에 저장합니다(경로 압축).union: 두 루트가 다르면 y 쪽 루트를 x 쪽 루트에 붙입니다.edges.sort(key=lambda e: e[2]): 간선을 세 번째 값인 가중치 기준으로 오름차순 정렬합니다.for u, w, weight in edges: 간선의 두 정점 u, w와 가중치 weight를 차례로 꺼냅니다. 두 정점이 연결되어 있지 않으면 합치고 비용을 더합니다.
예제의 간선을 정렬하면 (2, 3, 4), (0, 3, 5), (0, 2, 6), (0, 1, 10), (1, 3, 15) 순서가 됩니다. 진행 순서는 다음과 같습니다.
- 2-3(4)을 고릅니다. 비용은 4입니다.
- 0-3(5)을 고릅니다. 비용은 9입니다.
- 0-2(6)는 건너뜁니다. 0과 2는 3을 거쳐 이미 연결되어 있습니다.
- 0-1(10)을 고릅니다. 비용은 19입니다.
- 1-3(15)은 건너뜁니다. 1과 3은 이미 연결되어 있습니다.
가중치 4, 5, 10인 간선 세 개가 선택되어 결과는 19입니다.
6. 프림과 크루스칼 중 무엇을 고르나요?
| 항목 | 프림 | 크루스칼 |
| 기준 | 정점에서 시작해 넓혀 갑니다. | 간선을 싼 순서로 봅니다. |
| 쓰는 도구 | 우선순위 큐, 방문 집합 | 간선 정렬, 유니온-파인드 |
| 시간 복잡도 | 우선순위 큐로 구현하면 O(E log V) | O(E log E) |
| 잘 맞는 경우 | 간선이 많은 밀집 그래프 | 간선이 적은 희소 그래프 |
시간 복잡도는 입력이 커질 때 걸리는 시간이 어떤 식으로 늘어나는지 나타내는 표기입니다. O(E log E)는 걸리는 시간이 대략 간선 수 E에 log E를 곱한 값에 비례해 늘어난다는 뜻입니다.
- 정점이 V개일 때 간선은 최대 V × (V-1) / 2개입니다. 간선 수가 이 값에 가까우면 밀집 그래프라고 부릅니다.
- 간선 수가 V나 V log V 정도면 희소 그래프라고 부릅니다. 트리는 희소 그래프의 대표적인 예입니다.
- 간선 수 E는 V의 제곱을 넘지 않으므로 log E는 log V의 2배를 넘지 않습니다. 그래서 우선순위 큐로 구현한 프림과 크루스칼의 시간 복잡도는 같은 수준입니다.
- 간선이 아주 많은 밀집 그래프에서는 우선순위 큐 대신 배열로 프림을 구현하는 방법이 있습니다. 이때 시간 복잡도는 O(V²)이고, 간선 수와 상관없습니다.
두 알고리즘 중 어느 것을 써도 결과 비용은 같습니다.
7. 백준 1197번은 어떻게 풀었나요?
이 문제는 입력이 간선 목록으로 주어집니다. 그래서 간선을 정렬하는 크루스칼이 간단합니다. 순서는 다음과 같습니다.
- 간선을 (a, b, w)로 저장하고 가중치 순으로 정렬합니다.
- 유니온-파인드로 사이클이 생기는지 확인하면서 비용을 더합니다.
- 간선 V-1개를 고르면 반복을 멈춥니다.
정점 번호가 1부터 시작하므로 배열 크기를 V+1로 잡습니다.
import sys

def find(root, x):
    while root[x] != x:
        root[x] = root[root[x]]
        x = root[x]
    return x

v, e = map(int, sys.stdin.readline().split())
edges = [tuple(map(int, sys.stdin.readline().split())) for _ in range(e)]
edges.sort(key=lambda t: t[2])

root = list(range(v + 1))
cost, used = 0, 0
for a, b, w in edges:
    ra, rb = find(root, a), find(root, b)
    if ra != rb:
        root[rb] = ra
        cost += w
        used += 1
        if used == v - 1:
            break
print(cost)sys.stdin.readline(): 입력을 한 줄씩 빠르게 읽습니다.find: 루트를 찾을 때까지 위로 올라갑니다. 올라가면서root[x] = root[root[x]]로 x가 두 칸 위의 원소를 가리키게 합니다. 이렇게 하면 루트까지의 길이가 줄어듭니다. 경로 압축의 한 가지 방식입니다.edges.sort(key=lambda t: t[2]): 간선을 가중치 오름차순으로 정렬합니다.root = list(range(v + 1)): 0번부터 V번까지 모든 정점이 자기 자신을 루트로 가리키게 합니다.if ra != rb: 두 정점의 루트가 다르면 두 집합을 합치고, 가중치를 더하고, 고른 간선 수used를 1 늘립니다.if used == v - 1: break: 간선 V-1개를 골랐으면 MST가 완성된 것이므로 멈춥니다.
개념을 정리하고 나니 문제는 금방 풀렸습니다. 다만 코드를 작성하는 것과 제출해서 채점을 통과하는 것은 다른 일이었습니다. 코드 수정, 예제 실행, 제출 후 채점 확인은 각각 다른 단계입니다. 채점 통과까지 확인해야 문제를 끝낸 것입니다. 앞으로도 알고리즘 개념 때문에 막히면 이렇게 이론을 먼저 정리할 예정입니다.
자주 묻는 질문 (FAQ)
Q1. MST에서 간선은 왜 무방향인가요?
MST는 방향이 없는 그래프에서 정의합니다. 트리의 간선은 두 정점을 잇는 관계이고 방향이 없습니다. 코드에서 A의 목록에 B를 적고 B의 목록에 A를 적는 것은 이웃한 정점을 찾기 쉽게 하려는 표현입니다. (u, v, w)와 (v, u, w)는 같은 간선입니다.
Q2. 프림과 크루스칼 중 무엇을 써야 하나요?
간선이 적은 희소 그래프에서는 크루스칼이 구현하기 편합니다. 입력이 간선 목록으로 주어질 때도 크루스칼이 편합니다. 간선이 많은 밀집 그래프에서는 프림이 유리합니다. 결과 비용은 두 방법 모두 같습니다.
Q3. 유니온-파인드의 경로 압축은 왜 하나요?
find가 루트를 찾을 때 거치는 원소들을 루트에 바로 연결해 두면, 다음 호출에서는 한 번에 루트를 찾을 수 있습니다. 이 처리가 없으면 원소들이 한 줄로 길게 이어질 수 있습니다. 그러면 find를 부를 때마다 여러 단계를 거쳐야 합니다.
수정 안내
이 글은 2026년 11월 21일에 다시 썼습니다. 이전 판의 "방문 집합이 있어서 결과가 최소 비용이 된다"는 설명은 정확하지 않아 "이미 붙인 정점을 다시 붙이지 않아 비용을 두 번 더하지 않고 사이클이 생기지 않는다"로 고쳤습니다. "사이클이 있으면 최소가 될 수 없다"는 설명은 가중치가 0 이하인 간선이 있으면 맞지 않으므로 "사이클이 있으면 트리가 아니다"로 고쳤습니다. 두 알고리즘의 시간 복잡도와, 밀집 그래프에서 유리한 것은 배열로 구현한 프림이라는 설명을 더했습니다.
참고 자료
같은 주제의 다른 글: [자료구조/C언어] 레드-블랙 트리(Red-Black Tree) 규칙·회전·삽입·삭제 정리, [데이터베이스] DB 인덱스(Index) 핵심 원리: B-Tree 구조와 검색 성능 최적화, [알고리즘] 퀵 정렬(Quick Sort) 동작 원리와 시간 복잡도 분석: 피벗 선택과 분할 정복