[Unity] ML-Agents 강화학습 게임 AI: 관찰·행동·보상 설계와 학습 과정
TL;DR (세 줄 요약)
- 조건문으로 NPC를 만들면 상태(체력, 적 위치, 탄약, 부상병 수)가 늘어날수록 경우의 수가 곱으로 늘어납니다. 개발자가 적지 않은 조합에서는 NPC가 아무 행동도 하지 못합니다.
- ML-Agents는 세 단계를 반복합니다. 상태를 숫자 배열(관찰)로 넘깁니다. 신경망이 내놓은 행동 값을 실행합니다. 그 결과를 보상 숫자로 돌려줍니다. PPO 같은 알고리즘이 보상의 합이 커지는 방향으로 신경망을 조금씩 고칩니다.
- 결과를 좌우하는 것은 보상을 어떻게 주느냐입니다. 휴리스틱 모드로 환경이 제대로 동작하는지 먼저 확인하고, 강화학습으로 학습시키고, 사람의 플레이 기록이 있으면 모방학습으로 출발점을 앞당깁니다.
이 글은 Unity의 ML-Agents로 게임 AI를 학습시킬 때 사람이 정해야 하는 세 가지(관찰, 행동, 보상)와 학습 과정을 설명합니다. ML-Agents는 Unity가 만든 오픈소스 도구로, 게임 속 캐릭터를 강화학습으로 훈련시킵니다. 강화학습은 여러 번 시도해 보면서 보상을 많이 받는 행동을 스스로 찾아 가는 학습 방법입니다. 코드는 설명을 위한 예제입니다.
1. ML-Agents는 실제로 어떤 계산을 하나요?
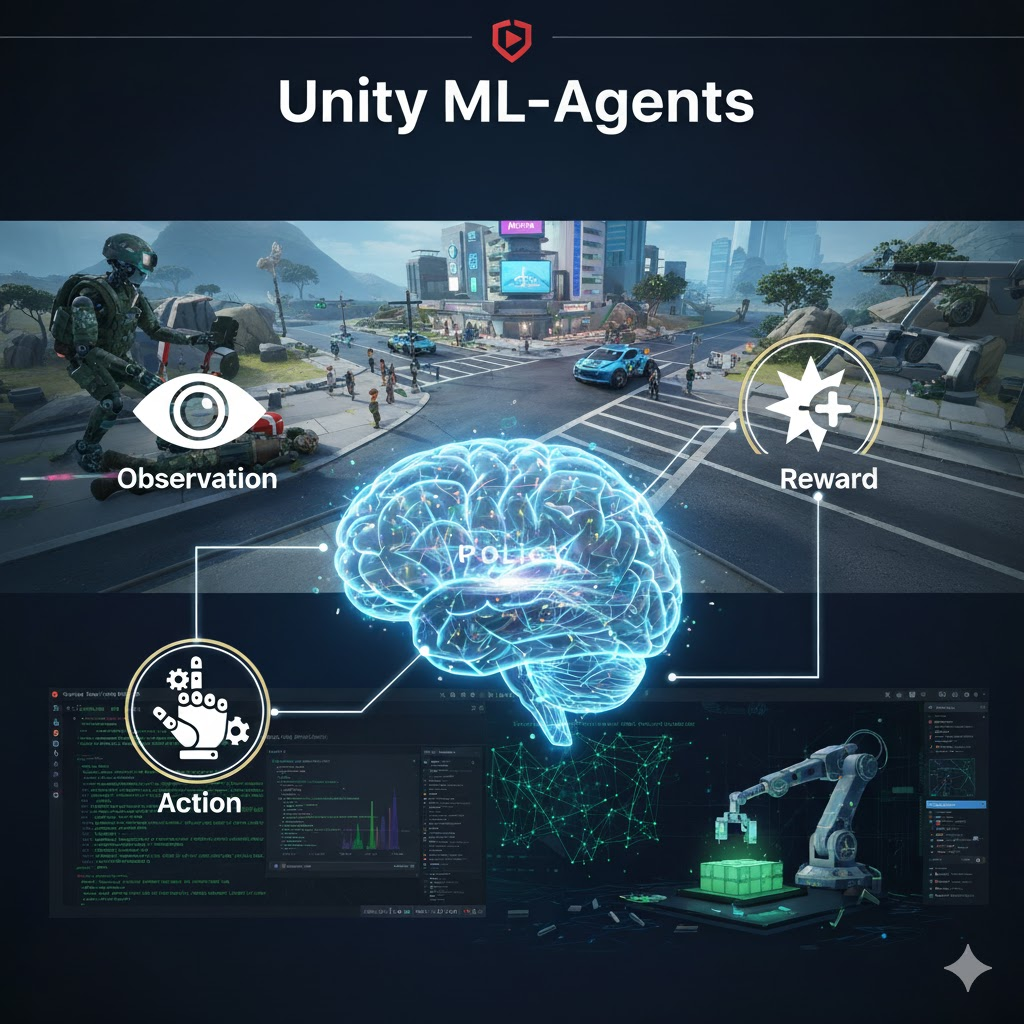
ML-Agents는 두 프로그램으로 이루어집니다. 하나는 게임 오브젝트에 붙는 C# 컴포넌트인 Agent(에이전트)입니다. 다른 하나는 따로 실행되는 Python 학습 프로그램입니다. 두 프로그램은 서로 연결되어 스텝마다 데이터를 주고받습니다. 스텝은 관찰하고 행동하는 한 번의 주기입니다.
- Agent가 주변 상태를 float 숫자 배열로 만들어 보냅니다. 이것이 관찰(Observation)입니다.
- 신경망이 그 배열을 입력으로 받아 행동 값(정수 또는 float)을 내놓습니다.
- Agent가 그 값을 실제 이동이나 공격으로 실행합니다.
- 환경이 바뀌고, Agent가 그 결과에 해당하는 보상 숫자를 더합니다.
- Python 쪽 학습기가 (관찰, 행동, 보상, 다음 관찰)을 모아 신경망의 가중치를 조금 고칩니다.
신경망은 숫자를 입력받아 여러 번 곱하고 더해 숫자를 내놓는 계산 구조입니다. 가중치는 그 계산에 쓰이는 숫자들이고, 학습으로 바뀌는 대상입니다.
| 단계 | 누가 정하나요? |
| 1번. 무엇을 볼지 (관찰) | 사람이 설계합니다. |
| 2번. 관찰을 보고 어떤 행동을 고를지 | 학습으로 채워집니다. |
| 3번. 무엇을 할 수 있는지 (행동) | 사람이 설계합니다. |
| 4번. 무엇을 잘한 것으로 볼지 (보상) | 사람이 설계합니다. |
2번의 함수를 정책(Policy)이라고 부릅니다. 정책은 관찰 배열을 입력받아 행동별 확률 또는 연속 값을 내놓는 함수입니다. 안쪽은 행렬 곱과 활성화 함수로 된 신경망입니다.
2. 규칙 기반 AI는 어디서 한계가 오나요?
조건문으로 만든 NPC는 사람이 적어 둔 조합 안에서만 동작합니다. NPC는 플레이어가 조종하지 않는 캐릭터입니다. 예를 들어 다친 아군을 치료하는 NPC를 만들려면 아래 조건을 모두 코드로 적어야 합니다.
- 부상병이 3명일 때 누구를 먼저 치료할지
- 적이 사거리 안에 있는지, 어느 방향에서 쏘는지
- 내 체력과 탄약이 남았는지
- 치료하는 동안 몸을 숨길 엄폐물이 있는지
각 항목의 가짓수를 곱한 만큼 조합이 생깁니다. 항목이 늘어날수록 조합의 수는 매우 빠르게 늘어납니다. 조건문이 많아지면 코드가 길어집니다. 개발자가 생각하지 못한 조합에서는 맞는 if 문이 하나도 없어서 NPC가 제자리에 서게 됩니다.
학습형 AI는 이 조합 표를 사람이 쓰지 않습니다. 시뮬레이션에서 얻은 보상의 합이 커지는 방향으로 신경망의 가중치를 조정해서 같은 역할을 하게 합니다.
3. 관찰(Observation)은 어떻게 정하나요?
관찰은 신경망의 입력입니다. 게임의 상태를 빠짐없이, 항상 같은 순서로, 같은 개수의 숫자로 바꿔야 합니다.
| 종류 | 예 | 넣는 방법 |
| 수치 관찰 | 위치, 속도, 체력, 남은 탄약, 적과의 거리 | CollectObservations 안에서 AddObservation으로 넣습니다. |
| 시각 관찰 | 카메라가 그린 이미지(픽셀 배열) | Camera Sensor나 RenderTexture Sensor 컴포넌트로 넣습니다. |
| 범주형 관찰 | 무기 종류처럼 정해진 항목 가운데 하나 | one-hot 벡터로 넣습니다. 고른 칸만 1이고 나머지는 0인 배열입니다. |
public override void CollectObservations(VectorSensor sensor)
{
    sensor.AddObservation(transform.localPosition);   // 3개
    sensor.AddObservation(health / maxHealth);        // 1개 (0~1)
    sensor.AddObservation((target.position - transform.position).normalized); // 3개
}
// Vector Sensor Size = 7transform.localPosition: 내 위치입니다. x, y, z 세 숫자가 들어갑니다.health / maxHealth: 체력을 최대 체력으로 나눈 값입니다. 0에서 1 사이의 숫자 하나가 됩니다.(target.position - transform.position).normalized: 목표가 있는 방향입니다. 길이를 1로 맞춘 세 숫자입니다.- 합치면 3 + 1 + 3 = 7개입니다.
관찰에서 주의할 점은 무엇인가요?
- 크기: Behavior Parameters 컴포넌트의 Vector Observation Space Size는
AddObservation으로 넣는 숫자의 개수와 정확히 같아야 합니다. 위 예제에서는 7입니다. - 범위: 값의 범위를 맞춥니다. 체력 3000을 그대로 넣고 거리는 0~1로 넣으면 큰 숫자가 학습에 지나치게 큰 영향을 줍니다. 그래서 모든 값을 나누어 0~1 또는 -1~1 근처로 만들어 넣습니다. 이렇게 범위를 맞추는 일을 정규화라고 부릅니다.
4. 행동(Action)은 어떻게 정하나요?
| 종류 | 뜻 | 예 |
| 이산 행동 (Discrete) | 정해진 선택지 가운데 하나를 고릅니다. 브랜치(branch)마다 선택지의 개수를 정합니다. 에이전트는 브랜치마다 고른 번호 하나를 받습니다. | 0번 브랜치에 4개(대기, 이동, 공격, 치료), 1번 브랜치에 8개(방향) |
| 연속 행동 (Continuous) | -1에서 1 사이의 실수입니다. 세밀하게 조절하는 값에 씁니다. | 조향 각도, 가속 페달 |
public override void OnActionReceived(ActionBuffers actions)
{
    int move = actions.DiscreteActions[0];   // 0~3
    float turn = actions.ContinuousActions[0];
    transform.Rotate(0f, turn * 180f * Time.deltaTime, 0f);
    if (move == 3) TryHeal();
}actions.DiscreteActions[0]: 0번 브랜치에서 고른 번호입니다. 0에서 3 사이의 정수입니다.actions.ContinuousActions[0]: 첫 번째 연속 행동 값입니다.transform.Rotate(...): 연속 값에 비례해 몸을 돌립니다.if (move == 3) TryHeal();: 고른 번호가 3이면 치료를 시도합니다.
행동을 잘게 나눌수록 학습이 어려워집니다. 처음에는 행동의 수를 적게 두고, 학습이 되면 늘립니다.
5. 보상(Reward)은 어떻게 설계하나요?
신경망은 보상의 합을 가장 크게 만드는 방향으로만 바뀝니다. 개발자가 바라는 목표와 보상 규칙이 어긋나면, 에이전트는 바라던 것과 다른 방법으로 보상을 모읍니다.
- 사건마다
AddReward로 보상을 더합니다. 예를 들어 치료 성공은 +1.0, 아군 사망은 -1.0, 내 사망은 -2.0을 줍니다. - 스텝마다 작은 음수를 주면 빨리 끝내는 행동을 배웁니다. 시간 제한을 두고 싶을 때 씁니다.
- 보상을 에피소드 끝에 한 번만 주면 학습이 매우 느립니다. 에피소드는 시작부터 끝까지의 한 판입니다. 거리가 줄었을 때나 시야를 확보했을 때 같은 중간 목표에 작은 보상을 줍니다.
- 같은 행동을 되풀이해서 보상을 쌓을 수 있으면 에이전트는 그 반복을 배웁니다. 보상은 한 번만 받도록 조건을 붙입니다.
public void Heal(Agent patient)
{
    if (patient.isDown)
    {
        patient.Revive();
        AddReward(1.0f);
    }
}
public void OnAllyDeath() { AddReward(-1.0f); }
public void OnSelfDeath() { AddReward(-2.0f); EndEpisode(); }
if (patient.isDown): 대상이 쓰러져 있을 때만 치료하고 보상을 줍니다. 이 조건이 보상을 되풀이해서 받는 일을 막습니다.AddReward(1.0f): 보상 1.0을 더합니다.EndEpisode(): 이번 판을 끝내고 처음부터 다시 시작합니다.
학습이 안 될 때 가장 먼저 볼 곳도 보상입니다. 보상의 크기가 한쪽으로 치우치면 문제가 생깁니다. 예를 들어 살아남는 보상이 다른 보상보다 훨씬 크면, 에이전트는 아무것도 하지 않고 버티는 행동을 배웁니다.
6. ML-Agents는 어떤 프로그램들로 이루어져 있나요?
| 구성 요소 | 하는 일 |
| Unity SDK | Agent, Behavior Parameters, Sensor 컴포넌트입니다. 관찰, 행동, 보상을 정의하고 실행합니다. |
| Python API (mlagents_envs 패키지) | Unity와 gRPC로 연결되어 관찰과 행동을 주고받습니다. gRPC는 프로그램끼리 통신하는 방식의 하나입니다. |
| Trainer (mlagents 패키지) | PPO, SAC, Behavioral Cloning(BC), GAIL 같은 학습 알고리즘을 구현한 부분입니다. 보상의 합이 커지도록 가중치를 고칩니다. |
| Wrapper | Unity 환경을 Gym API 형태로 감싸 다른 라이브러리에서도 쓸 수 있게 합니다. |
| Behavior | 한 종류의 에이전트가 쓰는 관찰, 행동, 보상 설정의 묶음입니다. 같은 씬에 치료병과 공격병을 서로 다른 Behavior로 둘 수 있습니다. |
7. 학습 모드 세 가지는 무엇인가요?
| 모드 | 동작 | 쓰는 때 |
| Heuristic (휴리스틱) | 신경망 없이 사람이 짠 코드나 키 입력으로 움직입니다. | 관찰 값이 제대로 들어오는지, 행동이 실제로 실행되는지 확인할 때 |
| 강화학습 | 시행착오로 정책을 학습합니다. | 시간이 오래 걸리지만 사람이 생각하지 못한 행동 조합을 찾을 수 있습니다. |
| 모방학습 | 사람이 플레이한 기록(관찰과 행동의 쌍)을 따라 배웁니다. | 빠르지만 시범의 실수까지 배웁니다. 그래서 보통 강화학습과 함께 씁니다(BC와 GAIL). |
8. 훈련과 추론은 어떻게 진행하나요?
훈련은 신경망의 가중치를 고쳐 가는 단계입니다. 추론은 다 고친 신경망을 써서 행동을 고르기만 하는 단계입니다.
# 학습 실행 (Python)
mlagents-learn config/medic.yaml --run-id=medic_v1

# 결과: results/medic_v1/Medic.onnxmlagents-learn: 학습을 시작하는 명령입니다.config/medic.yaml: 학습 설정을 적은 파일입니다.--run-id=medic_v1: 이번 학습에 붙이는 이름입니다. 결과가results/medic_v1폴더에 저장됩니다.
- Behavior Parameters의 Behavior Type을 Default로 둡니다.
- 터미널에서 위 명령을 실행합니다. Unity 에디터에서 Play를 누르라는 안내가 나오면 Play를 누릅니다. 학습이 시작됩니다.
- 학습이 끝나면 .onnx 파일이 생깁니다. ONNX는 신경망 모델을 저장하는 파일 형식입니다. 이 파일을 Behavior Parameters의 Model 칸에 넣습니다.
- Behavior Type을 Inference Only로 두면 Python 없이 게임 안에서 바로 추론합니다.
추론 단계에서는 가중치를 더 이상 바꾸지 않습니다. 관찰을 넣고 출력을 받아 실행하는 계산만 합니다. 이 계산에 드는 시간은 신경망이 클수록 늘어납니다.
9. 실제로는 어떤 순서로 진행하나요?
- Heuristic 모드로 관찰 값과 행동이 정확히 동작하는지 확인합니다.
- 보상 규칙을 문장으로 적습니다. "치료 성공 +1, 아군 사망 -1"처럼 사건과 숫자를 하나씩 짝짓습니다.
- 관찰 값의 범위를 0~1 근처로 정리합니다.
- 에이전트 한 종류와 적은 수의 행동으로 짧게 학습해 보고, 보상 그래프가 오르는지 봅니다.
- 오르면 에이전트의 수와 행동의 수를 늘립니다.
- 사람의 플레이 기록이 있으면 BC로 처음 정책을 만들고 강화학습으로 다듬습니다.
10. ML-Agents는 어디에 쓰이나요?
- 게임 NPC: 플레이어의 행동에 반응하는 전투 AI, 난이도 조절
- 로보틱스: 실제 로봇 대신 시뮬레이션에서 여러 번 시도해 걷기와 집기 동작을 학습
- 자율주행 시뮬레이션: 날씨와 도로 조건을 바꿔 가며 주행 정책을 학습
- 멀티에이전트 연구: 여러 개체의 협력과 경쟁, 포식자와 피식자 관계의 모델링
정리하면 세 문장입니다. 관찰은 신경망의 입력입니다. 행동은 신경망의 출력입니다. 보상은 가중치를 어느 방향으로 고칠지 정하는 숫자입니다. 사람이 설계하는 부분은 관찰, 행동, 보상 세 가지입니다. 그래서 학습이 안 될 때는 코드보다 보상 규칙과 관찰 값의 범위를 먼저 봅니다.
자주 묻는 질문 (FAQ)
Q1. Python과 머신러닝을 깊이 알아야 하나요?
환경은 Unity C#만으로 만들 수 있습니다. 학습은 mlagents-learn 명령과 yaml 설정 파일로 시작할 수 있습니다. 필요한 지식은 보상 설계, 관찰 값 정규화, 학습 스텝 수를 읽는 정도입니다. 다만 보상 그래프가 왜 오르지 않는지 판단하려면 PPO가 무엇을 크게 만들려고 하는지는 알아야 합니다.
Q2. 학습이 진행되지 않고 에이전트가 제자리만 돕니다. 무엇부터 확인해야 하나요?
보상 규칙부터 봅니다. 목표에 주는 보상이 너무 작거나 중간 행동에 보상이 몰려 있으면 엉뚱한 정책이 학습됩니다. 그다음에는 네 가지를 확인합니다. 관찰 값의 범위(정규화), Vector Observation Space Size와 AddObservation 개수가 맞는지, 에피소드가 끝나는 조건, 학습 스텝 수입니다.
Q3. 학습한 모델은 빌드에 어떻게 넣나요?
학습이 끝나면 .onnx 파일이 생깁니다. 이 파일을 Behavior Parameters의 Model 칸에 넣고 Behavior Type을 Inference Only로 둡니다. 그러면 빌드한 게임에서 Python 없이 추론합니다. 모델 파일은 에셋으로 들어가므로 그만큼 빌드 용량이 늘어납니다.
수정 안내
이 글은 2026년 11월 22일에 사실 확인을 거쳐 다시 썼습니다. 고친 내용은 다음과 같습니다.
- "이 과정이 초당 수십~수백 번 반복된다", "가중치 수천~수백만 개", "조합이 수천 개"처럼 근거를 확인할 수 없는 수치를 삭제했습니다.
- 설명 문장과 "행동" 절이 코드 블록 안에 들어가 있던 것을 바로잡았습니다.
- 학습 명령에서
--train옵션을 뺐습니다. 현재 공식 문서의 명령 형식에는 이 옵션이 없습니다. 명령을 먼저 실행하고 안내가 나오면 Play를 누르는 순서로 고쳤습니다. - Python API의 패키지 이름을 mlagents_envs로 고치고, Trainer가 mlagents 패키지라는 점을 밝혔습니다. 두 프로그램의 연결 방식은 gRPC로 통일해 적었습니다.
- "이 순서가 실전에서 가장 빠르다"는 표현은 근거가 없어 뺐습니다.
참고 자료
같은 주제의 다른 글: [UE5 렌더링] 텍스처에서 디스플레이까지: 언리얼 색 파이프라인과 sRGB vs Linear, [게임 엔진 비교] Unity C# vs Unreal C++: 메모리 관리, GC, 성능, 생산성, [게임 개발 방법론] 게임 개발의 애자일·스크럼 도입 사례 3가지: 스타트업·대기업·분산팀, [게임 디자인 패턴] 옵저버 패턴: Unity C# vs Unreal C++ 구현과 UML 구조, [Unity C#] Coroutine vs Thread vs UniTask·Awaitable 비교